
NVIDIA® Blackwell HGX™ B300
返回首页NVIDIA Blackwell HGX™ B300
产出性能提升 30 倍
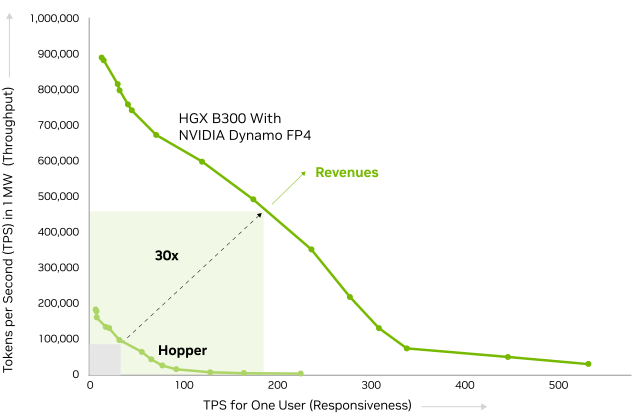
该曲线展示了决定 AI 工厂代币收益输出的关键参数。纵轴代表一兆瓦 (MW) AI 工厂的 GPU 每秒代币吞吐量 (TPS),横轴则量化了单个用户的交互性和响应速度(以 TPS 表示)。在吞吐量和响应速度的最佳交汇点,与NVIDIA Hopper 架构相比,HGX B300 可使 AI 工厂的整体输出性能提升 30 倍,从而实现最大的代币收益。
大型人工智能模型的可扩展训练
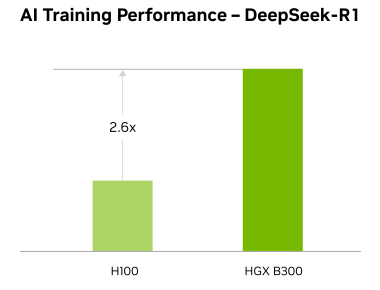
HGX B300 平台可为 DeepSeek-R1 等大型语言模型提供高达 2.6 倍的训练性能提升。凭借超过 2 TB 的高速内存和 14.4 TB/s 的 NVLink 交换机带宽,它能够实现大规模模型训练和高吞吐量的 GPU 间通信。
Blackwell Ultra 平台支持从 NVIDIA Cosmos™ 等世界基础模型实时生成视频,性能比 Hopper 提升 30 倍。这使得创建定制化、照片级真实感、时空稳定的视频成为可能,适用于物理 AI 应用。
技术突破
集成最新 NVIDIA 技术为 AI 工作负载提供前所未有的性能和效率
| 人工智能推理 与 NVIDIA Blackwell GPU 相比,NVIDIA Blackwell Ultra 的 Tensor Core 性能大幅提升,注意力层加速能力提升 2 倍,AI 计算浮点运算速度 (FLOPS) 提升 1.5 倍。 | 高容量 HBM3E 架构 NVIDIA Blackwell Ultra GPU 的 HBM3E 显存容量比上一代产品提升了 1.5 倍,并结合了更强大的 AI 计算能力,从而显著提升了 AI 推理吞吐量,尤其是在处理最长上下文时。 | 第五代 NVIDIA NVLink 要充分发挥加速计算的潜力,需要每个 GPU 之间实现无缝通信。第五代 NVIDIA NVLink™ 是一种可扩展互连技术,能够显著提升 AI 推理模型的性能。 |
| Feature | Specification |
|---|---|
| GPU Type | NVIDIA B300 Tensor Core GPU |
| GPU Memory | 288 GB |
| CPU Model | 2x Intel Xeon Emerald Rapids 6767P (SSTPP 2.7-2.9GHz) |
| Droplet vCPU | 224 |
| Droplet Memory | 3,600 GiB |
| Boot Disk (NVMe) | 2,046 GiB |
| Scratch Disk | 40,096 GiB |
| Transfer Allowance | 60 TB |
| GPU Fabric (GPU-to-GPU internal) | NVLINK - 800Gbps (6.4Tbps per node) |
| East/West Fabric (GPU-to-GPU multinode) | 8x800Gbps/GPU - 6.4Tb Total |
| Network Protocol | RoCEv2 |
| North/South Network (Public Egress/Ingress) | 10 Gbps public |
| VPC Network | 25 Gbps private |
重要提示
由于 B300 GPU 服务器采用最新的 NVIDIA Blackwell Ultra 架构,供应有限。建议提前预订以确保获得所需算力资源。
我们的技术团队将协助您评估具体需求,定制最适合您业务的配置方案。
NVIDIA HGX B300 技术规格
| HGX B300 | Specification |
|---|---|
| Form Factor | 8x NVIDIA Blackwell Ultra SXM |
| FP4 Tensor Core¹ | 144 PFLOPS | 108 PFLOPS |
| FP8/FP6 Tensor Core² | 72 PFLOPS |
| INT8 Tensor Core² | 3 POPS |
| FP16/BF16 Tensor Core² | 36 PFLOPS |
| TF32 Tensor Core² | 18 PFLOPS |
| FP32 | 600 TFLOPS |
| FP64/FP64 Tensor Core | 10 TFLOPS |
| Total Memory | 2.1 TB |
| NVIDIA NVLink | Fifth generation |
| NVIDIA NVLink Switch™ | NVLink 5 Switch |
| NVLink GPU-to-GPU Bandwidth | 1.8 TB/s |
| Total NVLink Bandwidth | 14.4 TB/s |
| Networking Bandwidth | 1.6 TB/s |
| Attention Performance³ | 2x |
B300 GPU 服务器采购指南
B300 价格、配置与租赁场景
围绕 B300 价格、B300服务器、NVIDIA B300 价格等采购关注点,把价格口径、配置差异、交付方式和相关文章集中呈现,帮助企业在询价前完成初步选型。
价格与配置关注点
B300 属于新一代 Blackwell 高端算力,价格通常受 GPU 数量、裸金属或集群交付、网络互联、存储容量、租期和供给窗口影响。适合先明确训练、推理或 DeepSeek 类模型部署需求,再由顾问给出按月、按集群或专属资源池报价。
核心关键词 B300 价格 / B300服务器 / NVIDIA B300 价格 | 推荐形态 裸金属 GPU、HGX 节点、专属 AI 集群 | 适合任务 大模型训练、高吞吐推理、长上下文与多模态任务 | 采购建议 提前锁定资源窗口,按显存、带宽和并发目标估算预算 |
适用场景
- 需要比 H100/H200 更高吞吐和更长生命周期的企业 AI 平台。
- DeepSeek、Qwen、Llama 等大模型训练、微调和推理集群。
- 已经有稳定 GPU 消耗,希望用专属资源池降低排队和供给风险。
- 需要同时评估 B300、H200、MI300X 成本和性能的采购团队。
GPU 与云服务器选型对比
B300 旗舰级 Blackwell 算力 适合预算明确、并发和模型规模较高的团队,重点看供给窗口和集群交付。 | H200 | H100 |
常见问题
B300 价格为什么不直接写固定数字?
B300 GPU 服务器价格会随资源形态、租期、节点数量、网络和存储方案变化。固定价格容易误导采购,建议用目标模型、并发量和预算区间来询价。
B300 适合直接替代 H100 吗?
如果目标是更高吞吐、更新架构和更长生命周期,B300 更适合作为升级方案;如果当前任务以成熟框架和成本控制为主,H100/H200 仍然值得对比。
B300 更适合训练还是推理?
两者都适合。训练场景重点看多卡互联和稳定供给,推理场景重点看显存、吞吐、批处理和服务峰值。